Actualización automática de la lista
GESTIÓN DE DOCUMENTOSActualiza periódicamente la lista de documentos para mostrar el estado del procesamiento.
Prepare las comunicaciones recibidas para su revisión.
Organice comunicaciones y extraiga datos clave para orientar su gestión.
Conozca el estado de cada documento y consulte la información obtenida.
Una primera mirada a lo que puede hacer con este producto.
Reúna comunicaciones en distintos formatos para iniciar su revisión.
Haga legibles los documentos escaneados y aproveche su contenido.
Revise cada comunicación con los datos clave extraídos de su contenido.
Organice oficios y trámites según el contenido y la terminología de su proceso.
Vea en qué etapa está cada documento y atienda oportunamente los errores.
Encuentre comunicaciones y consulte su información e historial cuando lo necesite.
Seleccione una categoría del mapa para consultar sus características.
Elija una categoría o busque en todas las características del producto. Recorra los resultados por páginas.
132 características
La búsqueda incluye todas las categorías.
Actualiza periódicamente la lista de documentos para mostrar el estado del procesamiento.
Para entornos sin servidor de almacenamiento en nube, los documentos pueden guardarse directamente en el sistema de archivos del servidor.
Todos los documentos cargados se guardan en un servidor de almacenamiento privado (MinIO), equivalente a un disco duro empresarial en la red interna.
El usuario puede tomar documentos desde su escritorio o carpetas y soltarlos directamente en la pantalla para subirlos, sin necesidad de buscar manualmente.
Permite seleccionar y cargar varios documentos en una misma operación.
El sistema no sube los archivos automáticamente; requiere que el usuario presione un botón de confirmación para iniciar la transferencia.
Permite descargar al computador del usuario el archivo original que fue cargado al sistema.
Antes de borrar documentos se muestra un mensaje de advertencia indicando los nombres de los archivos que serán eliminados, solicitando confirmación del usuario.
Botón de borrado en cada fila para eliminar un documento específico, con confirmación previa para evitar errores.
Cuando hay varios documentos seleccionados, aparece un botón que los elimina todos simultáneamente, con diálogo de confirmación.
Mientras la lista se refresca automáticamente, un ícono animado le indica al usuario que los datos están siendo actualizados.
Muestra los documentos de la organización en una tabla paginada con cantidad de registros configurable.
Admite archivos de hasta 50 MB.
El usuario puede ordenar la lista de documentos por nombre o por fecha de carga, haciendo clic en el encabezado de cada columna.
Si ya existe un documento con el mismo nombre en la organización, el sistema genera automáticamente un nombre alternativo agregando un número o sufijo, evitando sobrescrituras…
Botón de selección que abre el explorador de archivos del sistema para escoger uno o varios documentos a cargar.
Casillas de verificación en cada fila permiten seleccionar varios documentos a la vez para aplicarles acciones en lote.
El sistema acepta documentos en formato PDF, imágenes (JPG, JPEG, PNG, GIF) y documentos de texto (DOC, DOCX).
Antes de enviar los documentos al sistema, se muestra una lista de los archivos elegidos con su nombre, tamaño y tipo, permitiendo revisar y eliminar los no deseados.
Después del OCR, el texto se envía a un servicio especializado (Apache Tika) que extrae el contenido textual de manera más precisa desde el PDF procesado.
Clasifica oficios en categorías como requerimientos de entes de control, informes y circulares.
Clasifica trámites en categorías legales, entre ellas excepciones, prescripción, embargos y facilidades de pago.
Aplica flujos de decisión con IA para identificar el tipo de documento y ejecutar el clasificador correspondiente.
El sistema identifica automáticamente qué documentos requieren reconocimiento de texto (escaneados) y cuáles ya tienen texto digital, aplicando el proceso solo donde es necesario.
La IA analiza el cuerpo del documento para resumir los argumentos, razones o hechos que justifican su existencia o la solicitud contenida.
Extrae la petición o pretensión del remitente a partir del documento.
La IA identifica y extrae los términos jurídicos y administrativos más relevantes del documento, facilitando la búsqueda y referencia posterior.
El sistema detecta y extrae automáticamente el número o código de radicado/referencia del documento, si está presente.
Extrae remitente, destinatario, asunto, objetivo, resumen, términos legales y fecha de recepción mediante IA.
La inteligencia artificial determina si un documento es un Oficio (comunicación formal) o un Trámite (solicitud que requiere resolución administrativa), clasificándolo antes del…
El contenido de cada documento, junto con sus metadatos extraídos, se indexa en Apache Solr para permitir búsquedas rápidas y eficientes.
La tecnología de reconocimiento de texto puede cambiarse entre distintos motores (OcrMyPDF, Tesseract) según las necesidades de la organización, sin modificar el resto del sistema.
Para documentos escaneados o imágenes, el sistema convierte automáticamente el contenido visual en texto legible por computadora, permitiendo su posterior análisis.
Cada documento sigue una secuencia obligatoria: (1) Normalización del contenido → (2) Extracción de metadatos → (3) Clasificación.
El motor de reconocimiento óptico de caracteres procesa documentos en español e inglés simultáneamente, ideal para organizaciones con documentación bilingüe.
Cuando un documento está siendo procesado activamente (normalizando, extrayendo o clasificando), aparece un indicador giratorio sobre el chip correspondiente, informando al…
Las tareas tienen un número máximo de reintentos configurables; si fallan repetidamente, se detienen y registran el error para revisión.
Cada tarea registra su tiempo de inicio, permitiendo calcular cuánto tardó en completarse para análisis de rendimiento.
Las tareas de procesamiento pasan por estados claramente definidos: Pendiente → En Ejecución → Exitoso / Fallido, con registro de cada transición.
Cada documento en la lista muestra tres indicadores (N, E, C) que indican si ya fue Normalizado, Extraído y Clasificado respectivamente, con colores que distinguen los estados…
Después del procesamiento OCR, los archivos temporales generados durante el análisis se eliminan automáticamente del servidor para liberar espacio.
Aplica límites de tiempo a las tareas de normalización y extracción y cancela las que los superan.
Durante el procesamiento, el sistema actualiza mensajes descriptivos en tiempo real sobre lo que está haciendo: obteniendo el archivo, ejecutando OCR, enviando al motor de…
El sistema verifica antes de iniciar cualquier tarea si ya existe una en curso para el mismo documento y tipo de operación, evitando procesar el mismo archivo dos veces…
Cada operación de procesamiento se registra en la base de datos como una tarea con identificador único, tipo, estado, contador de acciones y mensajes de progreso.
El panel de detalles solo se habilita cuando el documento ya ha sido normalizado y tiene su contenido extraído, evitando mostrar información incompleta.
Vista expandible dentro de la tabla que muestra todos los metadatos extraídos del documento: categoría, subcategoría, origen, destinatario, asunto, resumen, objetivo…
Muestra quién creó el registro en el sistema, quién lo modificó por última vez y las fechas correspondientes.
Muestra la clasificación principal (Oficio/Trámite) y la subcategoría específica asignada por la IA a cada documento.
Muestra a quién fue dirigido el documento y su cargo u organización.
Muestra la fecha en que el documento fue recibido, tal como fue detectada por la IA en el contenido.
Muestra los argumentos y razones que sustentan la comunicación o solicitud del documento.
Presenta de forma clara la petición o pretensión concreta que contiene el documento.
Presenta quién envió el documento, a qué organización pertenece y su código o identificador de referencia.
Presenta un resumen generado por IA con los puntos más relevantes del contenido del documento.
Lista los términos jurídicos y administrativos detectados por la IA en el documento.
Actualiza el índice cuando un documento se procesa o cambia su información.
Las búsquedas pueden combinarse con filtros por campos específicos (categoría, fecha, origen, etc.) para resultados más precisos.
Permite buscar documentos usando palabras o frases que aparezcan en cualquier parte del contenido del documento, no solo en el título.
Cuando un documento es eliminado del sistema, también se borra del motor de búsqueda para mantener consistencia entre ambos.
Indexa el contenido y los metadatos de documentos en Apache Solr para su consulta.
Los resultados de búsqueda pueden ordenarse por diferentes campos y navegarse en páginas para manejar grandes volúmenes de documentos.
Antes de actualizar o eliminar registros en el motor de búsqueda, el sistema verifica que el documento exista en el índice, previniendo errores.
El sistema está dividido en componentes independientes: interfaz web, API, trabajadores de procesamiento, base de datos, motor de búsqueda, almacenamiento de archivos y servicio…
Encola las tareas de procesamiento en Redis.
Incluye reconexión automática al servicio de mensajería cuando se interrumpe la conexión.
Empaqueta los componentes en contenedores Docker para su despliegue y actualización.
Las tareas pesadas como el reconocimiento de texto y la clasificación con IA se ejecutan en segundo plano (con Celery), sin bloquear la interfaz del usuario ni afectar el…
Permite configurar el procesamiento simultáneo de documentos mediante trabajadores asíncronos.
Los componentes del sistema se comunican entre sí a través de una red privada virtual (Docker network), sin exponer servicios internos al exterior.
Configura el reinicio automático de los servicios ante fallos.
Separa el servidor web de los trabajadores de procesamiento de documentos.
El acceso al sistema se controla mediante tokens de seguridad (JWT) que verifican la identidad del usuario en cada operación, sin necesidad de enviar contraseñas repetidamente.
Cada petición del frontend al backend incluye automáticamente el token de seguridad en los encabezados HTTP.
Configura los orígenes autorizados para las solicitudes web mediante CORS.
Los usuarios pertenecen a grupos con roles específicos que determinan qué acciones pueden realizar dentro del sistema.
Los permisos del usuario se cargan al iniciar sesión y se almacenan en el estado global de la aplicación, estando disponibles en toda la interfaz sin consultas repetidas al…
Cada token de acceso contiene la identidad del usuario, su organización, correo electrónico, nombre de usuario e identificador de sesión, permitiendo una autorización precisa.
El sistema se conecta a la plataforma de autenticación central de Creangel Technologies para verificar usuarios y obtener sus permisos y grupos.
El sistema solo acepta formatos de archivo definidos en su configuración, rechazando cualquier archivo de tipo no permitido.
El sistema verifica que ningún archivo supere el límite de 50 MB antes de procesarlo.
Gestiona las credenciales de los servicios mediante variables de entorno.
En el panel de carga, el usuario puede filtrar los archivos seleccionados para subir escribiendo parte del nombre.
Cualquier URL que no corresponda a una página conocida es capturada y redirigida a la pantalla de error correspondiente.
Mientras se cargan los datos de la tabla, se muestra un indicador de progreso para que el usuario sepa que el sistema está trabajando.
Cuando un usuario accede a una dirección inexistente, se muestra una página amigable indicando que la ruta no fue encontrada, con opción de regresar.
Si ocurre un error inesperado en la aplicación, se muestra una pantalla de error amigable en lugar de una pantalla en blanco o un mensaje técnico.
Un menú desplegable en cada fila muestra las acciones disponibles según el estado del documento (Normalizar, Extraer, Clasificar), ocultando automáticamente las acciones ya…
Botones de anterior/siguiente página con contador que muestra el rango de registros actuales (ej: 1-10 de 45), facilitando la orientación en grandes listados.
Cuando algo falla, el sistema muestra un mensaje descriptivo indicando qué operación falló y en qué documento, ayudando al usuario a entender el problema.
El usuario puede cambiar cuántos documentos se muestran por página seleccionando entre opciones predefinidas (5, 10, 50, 100, 500).
Mantiene disponible el panel de carga mientras el usuario consulta la lista de documentos.
Sección dedicada con información sobre el proyecto, su equipo y contexto organizacional.
La página principal presenta el sistema IFindIT, su propósito y funcionalidades principales de forma visual.
Mensajes informativos emergen en la pantalla informando el resultado de cada operación (carga exitosa, error al clasificar, proceso iniciado, etc.), desapareciendo automáticamente…
Solicita a la IA resultados estructurados en JSON para su procesamiento por el sistema.
Utiliza invocación de herramientas para solicitar clasificaciones estructuradas.
El flujo de clasificación se modela como un grafo de estados con LangGraph, permitiendo ramificaciones condicionales (Oficio vs.
El sistema utiliza el modelo de lenguaje GPT-4o Mini de OpenAI para realizar la extracción de metadatos y la clasificación de documentos, aprovechando sus capacidades de…
Si la IA no devuelve una respuesta válida o falla, el sistema captura el error y continúa con un valor por defecto, evitando la interrupción del proceso.
Utiliza instrucciones de clasificación con definiciones de documentos y terminología jurídica colombiana.
Configura el modelo con temperatura cero para reducir la variación en las clasificaciones.
LangChain se utiliza como capa de abstracción para construir los flujos de conversación con la IA, facilitando el mantenimiento y la evolución del sistema.
Toda la información del sistema (documentos, metadatos, tareas) se almacena en una base de datos PostgreSQL.
Al eliminar un documento, sus metadatos asociados se eliminan automáticamente, manteniendo la integridad referencial de la base de datos.
La API soporta filtros complejos en los listados de documentos, incluyendo búsqueda por texto en campos específicos, ordenamiento y paginación.
La información extraída por IA (categoría, subcategoría, resumen, términos, etc.) se almacena en una tabla independiente vinculada al documento, manteniendo el modelo de datos…
Los cambios en la estructura de la base de datos se gestionan mediante Alembic, permitiendo actualizar el esquema de forma controlada y versionada.
Cada documento registra su estado en el pipeline: si requiere OCR, si su contenido fue normalizado, si está bajo normalización, si fue extraído, si está bajo extracción, si fue…
Cada registro en la base de datos guarda quién lo creó, quién lo modificó por última vez, y las fechas de creación y edición.
El sistema permite que no puedan existir dos documentos con el mismo nombre dentro de la misma organización, previniendo duplicados.
Los términos legales extraídos se almacenan como arreglos de texto en PostgreSQL, permitiendo múltiples valores en un solo campo.
Todos los servicios del sistema están disponibles a través de una API REST bajo la ruta /v1/, facilitando el mantenimiento y la compatibilidad con versiones futuras.
Permite modificar el nombre de un documento existente.
Inicia el proceso de clasificación con IA para un documento específico, devolviendo un ticket de tarea.
Permite obtener la información detallada de un documento específico usando su identificador único.
Permite obtener todos los metadatos extraídos de un documento (categoría, subcategoría, resumen, términos legales, etc.).
Permite cargar uno o más archivos al sistema en una sola solicitud, creando los registros correspondientes en la base de datos.
Permite descargar el archivo original del documento tal como fue cargado.
Elimina un documento del sistema, incluyendo su archivo en el almacenamiento, su registro en el motor de búsqueda y todos sus metadatos.
Inicia el proceso de extracción de metadatos con IA para un documento específico, devolviendo un ticket de tarea.
Permite obtener listas de documentos con opciones de paginación, ordenamiento, filtrado y conteo total.
Inicia el proceso de OCR para un documento específico en segundo plano, devolviendo un ticket de tarea para seguimiento.
Todas las respuestas de la API siguen un formato uniforme con campos de estado, mensaje y datos, facilitando su integración con otras aplicaciones.
Microservicio independiente basado en Apache Tika que recibe archivos PDF y devuelve su contenido textual; soporta PDF, DOC, DOCX y TXT.
Las notificaciones de éxito o error se gestionan a través del estado global.
La aplicación web utiliza Redux para manejar un estado centralizado.
El sistema controla dinámicamente qué acciones están disponibles para el usuario según el estado actual de la aplicación.
Los datos de la organización a la que pertenece el usuario se cargan al inicio y se mantienen disponibles en toda la sesión.
El nombre, identificador, correo y otros datos del usuario conectado se almacenan en el estado global y están disponibles en toda la aplicación.
Los grupos y roles del usuario se almacenan en el estado global, permitiendo mostrar u ocultar funcionalidades según los permisos.
El estado de la sesión del usuario se guarda en el almacenamiento del navegador para mantener la sesión activa si el usuario recarga la página.
No encontramos características con esos términos. Intente una palabra diferente.
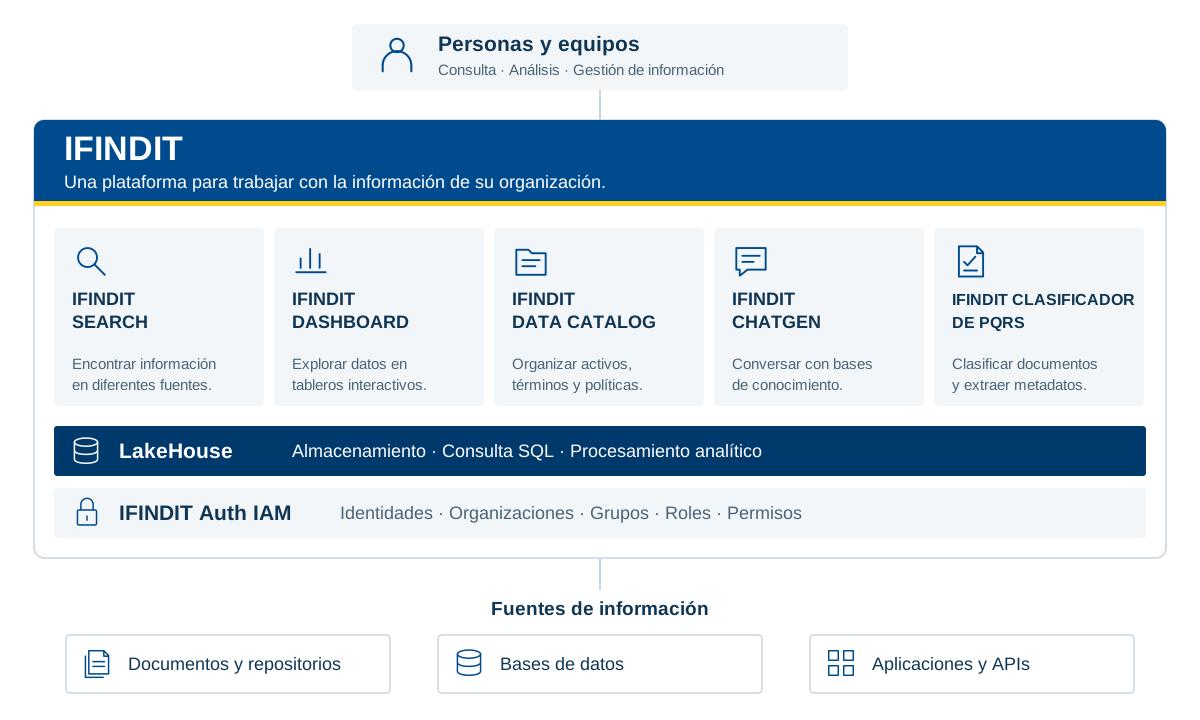
Explore cómo se relaciona con los demás productos y las capacidades compartidas.
Consulta · Análisis · Gestión de información
Documentos y repositorios · Bases de datos · Aplicaciones y APIs
Una vista funcional de IFINDIT y sus capacidades compartidas. Cada producto conecta necesidades distintas de la organización.
Ver arquitectura de la plataforma (SVG)Cuéntenos qué necesita encontrar, analizar u organizar. Conozca IFINDIT con el equipo de Creangel.